
算力精算强底座 鲲鹏展翅启新程——湛江市司法局特邀华为技术专家作算力测算专题授课
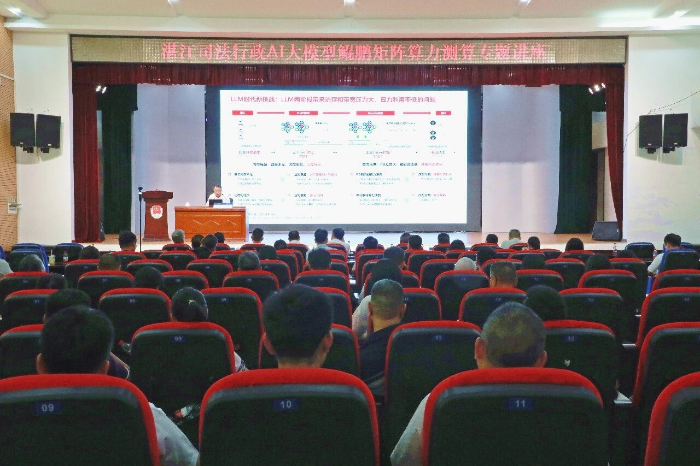
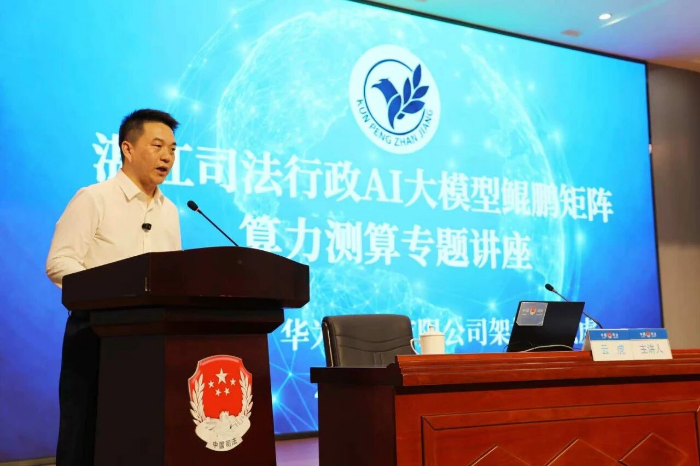
9月28日下午,继上午成功举办“从单一到集成,从赋能到高效协同”——湛江司法行政Harness底座建成暨鲲鹏矩阵第二期成果新闻发布会后,湛江市司法局紧接着举办算力测算专题讲座,特邀华为技术有限公司架构师云虎前来授课,为全系统干部职工系统讲解算力测算与规划配置知识。局党组成员、副局长朱罗成作开场致辞,全市司法行政系统相关人员参加培训。
朱罗成在致辞中回顾,一年前的今天,全国首个司法行政综合垂直大模型“鲲鹏矩阵”正式发布;一年来,系统从1.0迭代至4.7.7版本,完成9次重要升级,开发智能体200余个,覆盖行政复议、社区矫正、人民调解、法治审查等20个核心业务板块,市、县、镇三级联动体系初步建成。朱罗成认为,华为作为我国科技自立自强的标杆企业,其自主可控的技术路线与我们“需求导向、场景优先、安全可控”的建设理念高度契合。他代表局党组和全体干警,向华为技术团队的到来表示热烈欢迎,向华为长期以来给予湛江司法行政的关心支持表示衷心感谢。
当天上午,Harness底座正式建成,近200余个智能体归集于统一工程化框架,鲲鹏矩阵迈入“统一底座、统一治理、统一承载、统一协作”的新阶段。规模越大、用户越多,算力如何科学测算、合理配置、高效调度,成为必须回答好的现实课题。特别是前期建设中,部分算力设备采购后性能未能充分释放,对算力需求的测算存在偏差;基层司法局财力有限,如何把有限经费用在刀刃上、部署性价比最优的算力方案,更是亟待破解的难题。华为架构师云虎老师此次授课恰逢其时、十分解渴。
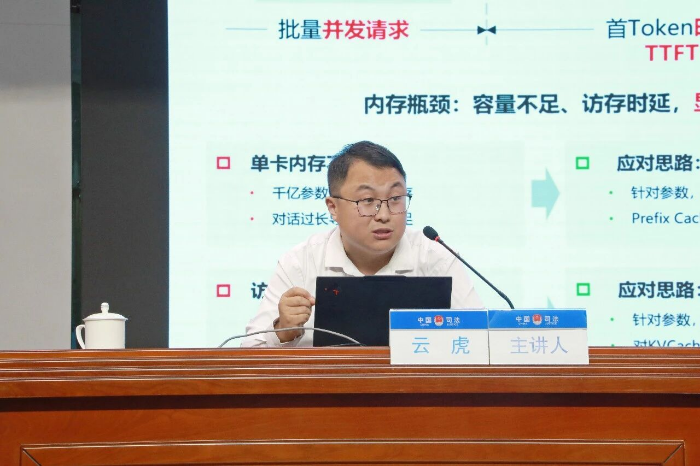
授课中,云虎老师围绕算力需求测算、资源规划配置、大模型落地算力支撑等内容,结合华为昇腾在政法行业的实践,由浅入深系统讲解。他从智能体运行架构讲起,拆解LLM与Agent的分工协作逻辑;聚焦vLLM推理性能优化,介绍PD分离部署、模型量化压缩、张量并行与专家并行、KV Cache分级缓存、投机解码等关键技术——其中PD分离方案可提升系统有效吞吐50%以上,KV Cache三级缓存可使首Token时延下降超过25%;围绕智能体安全,剖析了删库删表、凭证盗用、数据篡改等风险及最小权限、沙箱隔离、全链路审计等应对策略;还介绍了SMECE使能套件中的KADT一键部署、KAOP统一监控、NPU算力切分、AI网关智能路由等实用工具,以及鲲鹏、昇腾产品分级分档体系,帮助基层单位科学选型、避免盲目采购。
讲座中,云虎专门分享了湛江司法局的实践案例:此前我局4张华为Atlas 300I A2推理卡性能不及预期,经华为技术团队3轮优化,通过部署方式调整,系统吞吐从20—60 Tokens/秒提升至68—96 Tokens/秒,性能提升3倍以上、设备利用率翻番。这一身边案例让参训同志深受启发——好设备更要好方法,算力不是“买来就管用”,科学测算和精细调优才能把每一分钱都花出效益。
授课结束后进入提问交流环节。参训同志结合本单位算力部署实际踊跃提问,有的询问基层“算力盒子”扩容选型,有的关注Harness底座下多智能体并发的算力调度,有的探讨大小模型混合部署的资源切分策略,云虎逐一耐心解答,现场气氛热烈。
整场讲座内容紧扣鲲鹏矩阵建设实际,既有原理层面的系统讲解,又有身边案例的生动剖析,参训同志纷纷表示收获颇丰。
当晚,鲲鹏天团完成Qwen3.8-w8a8模型部署,结合华为的优化参数进行优化后,模型单流已达170Token/s。又较之前的96Token/s提升了将近一倍,较6月30日21Token/s提高了9倍。在行政复议办案平台,上一个版本通过脚本完成正则表达的优化,已经实现Tokens消耗下降26-30%,时间消耗下降26-28%。本次对Qwen3.8和Qwen3.8-w8a8实行智能路由后,在完全不影响输出质量的前提下,可以在上一轮优化的基础上再节省36%的Tokens,算力消耗大幅下降,但输出时间无明显变化。在行政复议所有相关Skills中,关闭大模型思考模式对输出质量无任何影响,但时间消耗下降超过95%,一个案件输出从51分钟降到2.5分钟。这次测试对12个行政复议Skills +办案平台全部功能做推理难度分级,并在9个真实任务上对比三种方式(单一8006端口深度推理档/单一8007端口普通推理档/按推理难度智能路由),再叠加测试「思考模式开Vs关」对质量的影响。同日,Deepseek发布Harness桌面版,Harness使用将越来越好。
下一步,湛江市司法局将以Harness底座建成为新起点,深化与华为等科技企业的战略合作,联合研发更适配基层场景的轻量化算力解决方案,为鲲鹏矩阵规模化推广打好算力底座,努力为智慧司法行政建设贡献可复制、可推广的“湛江经验”。

 粤公网安备 44080202000041号